
この記事の要点
- 結論:今回の検証条件では、300dpiと600dpiのテキスト化結果に明確な差は確認されなかった。300dpiを標準的なスキャン解像度とすることは妥当と考えられる。
- 課題:ルビや「贔屓」のような画数の多い漢字は、600dpiに上げても誤認識が解消されないケースがあった。
- 対策:AIエンジンによって結果が異なるため、複数エンジンの結果比較、AIによる校正、元のスキャン画像との照合を組み合わせる。
- 検証条件:文庫本と一般文書を300dpi・600dpiでスキャンし、ページ全体の画像をGemini・Copilot・ChatGPT・Claudeの無料版に入力して比較。定量評価は未実施。
はじめに
RAG(検索拡張生成)や生成AIを活用する際、書籍や紙の文書をテキスト化し、AIが参照できるデータとして整備するケースがあります。
こうした用途では、元の文書をできるだけ正確にテキスト化することが重要です。一方で、スキャンの解像度を高くすればするほど、認識精度も向上するのでしょうか。
従来のOCR(光学文字認識)では、文字の細部を読み取りやすくするため、600dpiなどの高解像度でのスキャンが推奨されることがありました。しかし、近年のAIエンジンでは、従来とは異なる結果が得られる可能性があります。
そこで今回は、文庫本と一般文書を対象に、300dpiと600dpiでスキャンしたデータを複数のAIエンジンでテキスト化し、認識結果を比較しました。
300dpi / 600dpi
文庫本・一般文書
複数AIエンジンの認識結果を比較。定量評価は未実施。
1. 300dpiと600dpiの比較結果
今回の検証では、文庫本と一般文書を300dpiおよび600dpiでスキャンし、複数のAIエンジンを使用してテキスト化の結果を比較しました。
その結果、今回利用したAIエンジンでは、300dpiと600dpiの間で、認識結果に明確な差は確認されませんでした。
従来のOCRでは、文字の輪郭や細かな部分を読み取りやすくするために、高解像度の画像が重視されてきました。しかし、今回の検証では、解像度を600dpiに上げても、300dpiと比べて認識結果が明確に改善する傾向は確認できませんでした。
このことから、今回検証した文書とAIエンジンの条件では、300dpiを標準的なスキャン解像度として採用することは妥当と考えられます。高解像度でスキャンすると画像データの容量が大きくなるため、300dpiで必要な品質を確保できれば、データの取り扱いや処理の効率化にもつながる可能性があります。
比較用画像:以下は提供された300dpi・600dpiのスキャン画像です。表示倍率や画面サイズで見え方が変わるため、画像の見た目だけで文字認識精度を判断することはできません。
比較画像:同じ文章の300dpi・600dpiスキャン
左右に並べるか、片方ずつ表示して細部を確認できます。
300dpi
画像 A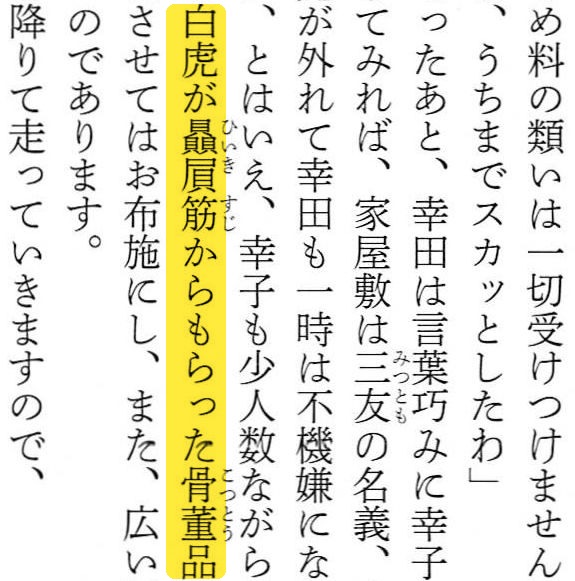
300dpiのスキャン画像
600dpi
画像 B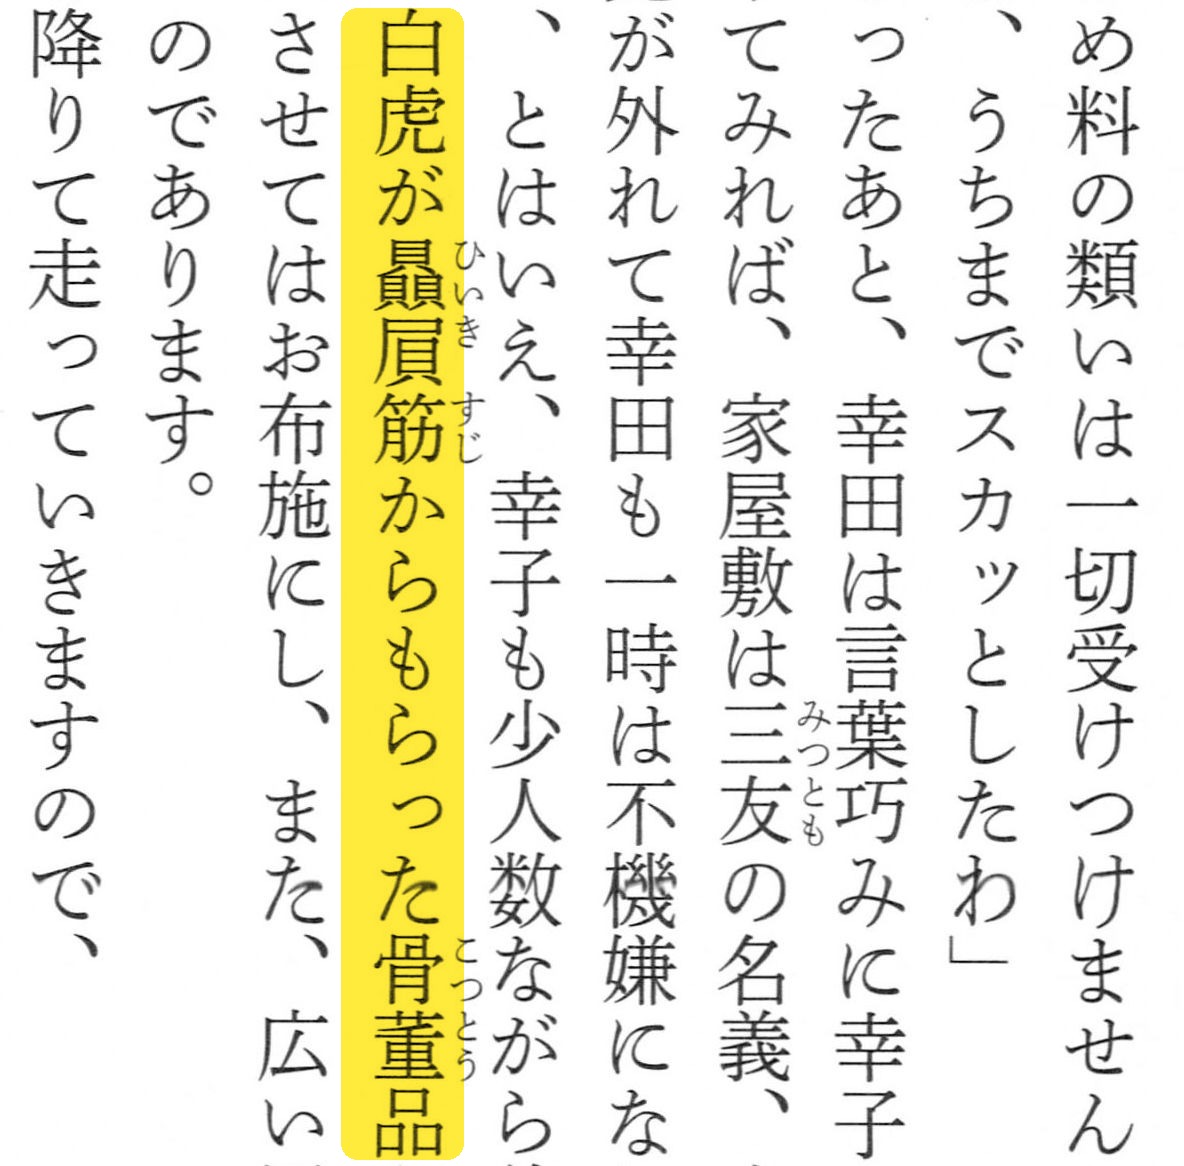
600dpiのスキャン画像
出典:検証に使用した画像は、吉田修一『国宝 下 花道篇』(朝日文庫)の一部です。
実験に使った画像について:ここに掲載している画像は、比較用に該当部分を切り出したものです。実際の検証では、この画像ではなく、ページ全体の画像をAIエンジンに入力しています。そのため、AIは文字の形だけでなく、前後の文脈などページ全体の情報も含めて処理しています。
比較時の注意:この図はスキャン画像を目視で比較するためのものです。認識精度を確認するには、各画像をAIエンジンに入力して得られたテキストも併せて確認する必要があります。
ただし、今回は認識精度の定量評価を行っていません。あくまでテキスト化した結果を比較した検証であり、すべての文書やAIエンジンにおいて300dpiと600dpiの精度が同等であると結論づけるものではありません。
2. 実験結果:AIエンジンごとのテキスト化比較
実際の文章「白虎が贔屓筋(ひいきすじ)からもらった骨董(こっとう)品」を対象に、Gemini、Copilot、ChatGPT、Claudeでテキスト化した結果を比較しました。各サービスの無料版を使用し、Geminiは「Gemini 3 自動モード」、Copilotは「Auto」で実行しています。
なお、AIエンジンに入力したのは、第1章に掲載した切り出し画像ではなく、ページ全体の画像です。AIは該当の1行だけでなく、前後の文脈なども含めて処理しています。
以下は、各AIエンジンが300dpi・600dpiの画像から出力したテキストです。誤認識や表記の違いが確認できるよう、結果を原文と並べて掲載します。
白虎が贔屓筋(ひいきすじ)からもらった骨董(こっとう)品
Gemini(無料版:Gemini 3 自動モード)
| 解像度 | テキスト化結果 | 原文との差異 |
|---|---|---|
| 300dpi | 白虎が贔屓筋(ひいきすじ)からもらった骨董品(こうとう) | 「骨董」のルビが「こっとう」ではなく「こうとう」と出力された。また、ルビが「骨董」ではなく「骨董品」の後ろに付いた。 |
| 600dpi | 白虎が贔屓筋(ひいきすじ)からもらった骨董品(こうとう) | 300dpiと同じ結果。解像度を上げても、「骨董」のルビの誤りやルビの位置は解消されなかった。 |
Copilot(無料版:Auto)
| 解像度 | テキスト化結果 | 原文との差異 |
|---|---|---|
| 300dpi | 白虎が眞廣筋(ひろすじ)からもろうた骨董品 | 「贔屓筋」を「眞廣筋」と認識し、ルビも「ひろすじ」と異なる。また「もらった」が「もろうた」となり、「骨董」のルビ「こっとう」は出力されなかった。 |
| 600dpi | 白虎が眞廣筋《ひいきすじ》からもろうた骨董品 | 本文の漢字誤認識と「もろうた」という表記は残った。一方、「筋」のルビは正しい「ひいきすじ」と出力された(括弧は《》)。「骨董」のルビ「こっとう」は出力されなかった。 |
ChatGPT(無料版)
| 解像度 | テキスト化結果 | 原文との差異 |
|---|---|---|
| 300dpi | 白虎が眷属筋(けんぞくすじ)からもらった骨董品(こっとうひん) | 「贔屓筋」を「眷属筋」と認識し、ルビも「けんぞくすじ」と異なる。「もらった」と「骨董品」の漢字は原文どおりだが、ルビは「こっとう」ではなく、「品」まで含めた「こっとうひん」と出力された。 |
| 600dpi | 白虎が眷属筋(けんぞくすじ)からもらった骨董品(こっとうひん) | 300dpiと同じ結果。「贔屓筋」の誤認識は解消されなかった。 |
Claude(無料版)
| 解像度 | テキスト化結果 | 原文との差異 |
|---|---|---|
| 300dpi・600dpi | (テキスト化されず)「この画像は市販の小説の1ページで、全文を一字一句そのまま書き起こすと著作物の相当部分をそのまま複製することになるため、お手伝いできません。」と回答。 | 処理できなかった。書籍1ページ分の書き起こしが著作物の複製にあたると判断され、テキスト化が行われなかったため、認識精度は比較できない。 |
結果から分かること
- 解像度を上げても結果が変わらない例:GeminiとChatGPTでは、300dpiと600dpiの出力結果が同じでした。今回の例では、解像度を600dpiに上げても、それぞれの誤認識は解消されませんでした。
- 解像度によって一部の出力が変わった例:Copilotでは、600dpiの出力で「筋」のルビが「ひろすじ」から正しい「ひいきすじ」に変わりました。ただし、「贔屓筋」の漢字認識や「もらった」の表記は原文と異なるままで、「骨董」のルビも出力されませんでした。
- 処理自体が行われない例:Claudeの無料版では、書籍1ページ分の書き起こしが著作物の複製にあたるとして断られ、テキスト化できませんでした。書籍のスキャン画像を扱う場合、サービスによってはこのように処理自体が行われないことがあります。
- AIエンジンごとの違い:「贔屓筋」の認識は、Geminiでは「贔屓筋」、Copilotでは「眞廣筋」、ChatGPTでは「眷属筋」と異なりました。エンジンによって誤認識の仕方が異なることが分かります。
- 本文とルビを分けて確認する必要性:ルビや周辺の文章が自然に出力されていても、本文の漢字が誤っている場合があります。また、ルビの読みや付く範囲(「骨董」か「骨董品」か)が原文と異なる出力もありました。必要に応じて、元画像との照合が重要です。
注:この比較は、記載したサービス・モード・入力画像で得られた個別の結果です。定量評価や多数の文書を用いた検証ではないため、各サービス全般の性能を順位づけるものではありません。
3. 小さな文字や画数の多い漢字では課題が残る
300dpiと600dpiで明確な差が確認されなかった一方、文庫本のように文字が小さい資料では、認識が難しいケースも見られました。
3-1. ルビは解像度を上げても誤認識が解消されないことがある
文庫本などに使われるルビは、本文よりも文字が小さく、AIによる認識を誤りやすいことが確認されました。今回の検証では、600dpiに解像度を上げても、ルビの誤認識が解消されないケースがありました。
一方、AIに認識結果を校正させることで、正しく認識されるようになるケースも確認されています。この結果から、ルビのような小さな文字については、スキャン解像度を上げるだけでなく、認識後の校正処理を組み合わせることが重要と考えられます。
ただし、校正の際には、AIが文脈から文字を推測して誤った修正を行う可能性もあります。正確性が求められるデータでは、元のスキャン画像と照合することが望まれます。
3-2. 画数の多い漢字はAIエンジンによって認識結果が異なる
「贔屓」のような画数の多い漢字についても、使用するAIエンジンによっては正しく認識できないケースが確認されました。こうした誤認識については、600dpiに解像度を上げても改善が見られないケースがありました。
つまり、文字をより細かく読み取れる画像にすることだけでは、すべての誤認識を解消できるわけではありません。複雑な漢字を正しく認識できるかどうかは、使用するAIエンジンにも左右されます。そのため、解像度を上げることだけに頼らず、別のAIエンジンによる認識や、認識結果の比較・校正を検討する必要があります。
4. AIエンジンによってテキスト化の結果は異なる
今回の検証では、解像度の違いだけでなく、使用するAIエンジンによっても認識結果に違いが生じることが確認されました。同じ文書をテキスト化しても、AIエンジンによって正しく認識できる文字や、誤認識が発生する箇所が異なる場合があります。
そこで、テキスト化の品質を高める方法として考えられるのが、複数のAIエンジンを利用し、それぞれの結果を比較して校正する方法です。
- スキャンした文書を複数のAIエンジンでテキスト化する。
- 各エンジンの認識結果を比較し、異なる箇所を抽出する。
- 元のスキャン画像や前後の文脈を参照しながら、AIを利用して校正する。
- 必要に応じて原文と照合し、修正後のテキストを確定する。
複数の認識結果を比較することで、単一のAIエンジンでは見つけにくい誤認識を発見しやすくなります。ただし、複数のAIエンジンが同じ誤認識をする可能性もあるため、結果が一致していることだけで正しいと判断するのは避けるべきです。重要な箇所については、元の画像を確認することが大切です。
5. RAGや生成AIの参照データを作成する際のポイント
RAGは、外部の文書やデータを検索し、その情報を生成AIの回答に活用する仕組みです。書籍や紙の資料を参照データとして利用する場合、スキャンした画像をテキスト化し、検索や回答生成に使える状態に整備する必要があります。
このとき、テキスト化の誤りは、検索結果や生成AIの回答にも影響する可能性があります。例えば、専門用語や人名、固有名詞などが誤認識されると、検索時に目的の情報を見つけにくくなったり、生成AIが誤った内容を参照したりする原因になり得ます。
今回の検証結果を踏まえると、次のような方針が考えられます。
| 資料・用途 | 推奨する対応 |
|---|---|
| 一般的な文書 | 300dpiを基本としてテキスト化する。 |
| 小さな文字やルビを含む文書 | ルビや小さな文字の認識結果を重点的に確認する。 |
| 画数の多い漢字や専門用語を含む文書 | 複数のAIエンジンの結果を比較し、誤認識がないか確認する。 |
| RAG・生成AIの参照データ | 必要に応じて校正や原文との照合を行い、データの品質を確認する。 |
すべての文書を一律に高解像度でスキャンするよりも、300dpiを基本とし、認識が難しい箇所を校正処理で補う方法は、効率と品質の両立を検討するうえで有力な選択肢です。
6. まとめ:解像度だけでなく、認識後の校正が重要
今回、文庫本と一般文書を対象に、300dpiと600dpiでスキャンしたデータを複数のAIエンジンでテキスト化し、結果を比較しました。
- 今回の検証条件では、300dpiと600dpiで認識結果に明確な差は確認されなかった。
- ルビの誤認識は、解像度を上げても解消されないケースがあった。
- 「贔屓」のような画数の多い漢字は、AIエンジンによって認識結果が異なり、解像度を上げても改善しないケースがあった。
- 複数のAIエンジンを利用すると、テキスト化の結果に違いが生じることが確認された。
特に、RAGや生成AIの参照データを作成する場合は、データを大量にテキスト化する効率だけでなく、誤認識をどのように発見し、修正するかという視点も重要です。
高解像度でスキャンすることだけを目指すのではなく、適切な解像度で取り込み、AIによる認識と校正を組み合わせてデータの品質を高める。今回の検証から得られたのは、そうしたテキスト化の進め方を検討するための知見です。
なお、今回の検証では認識精度の定量評価は行っていないため、今後、対象文書やAIエンジンを変えながら、より客観的な評価を行うことも課題となります。
よくある質問
AIでテキスト化するなら、300dpiと600dpiのどちらでスキャンすべき?
今回の検証条件(文庫本と一般文書、Gemini・Copilot・ChatGPTの無料版)では、300dpiと600dpiで認識結果に明確な差は確認されませんでした。そのため、300dpiを標準的なスキャン解像度とすることは妥当と考えられます。ただし、認識精度の定量評価は行っておらず、すべての文書やAIエンジンで同等と結論づけるものではありません。
600dpiでスキャンすれば、ルビや画数の多い漢字の誤認識は減る?
今回の検証では、ルビや「贔屓」のような画数の多い漢字の誤認識は、600dpiに上げても解消されないケースがありました。解像度を上げるだけでなく、複数のAIエンジンによる認識結果の比較や、認識後の校正、元のスキャン画像との照合が重要です。
書籍のスキャン画像を、AIでテキスト化できないことはある?
あります。今回の検証では、Claudeの無料版で、書籍1ページ分の書き起こしが著作物の複製にあたるとして断られ、処理できませんでした。サービスによっては、このように処理自体が行われない場合があります。
RAGや生成AIの参照データを作るとき、テキスト化で注意すべきことは?
テキスト化の誤りは、検索結果や生成AIの回答に影響する可能性があります。専門用語、人名、固有名詞などは特に誤認識に注意し、必要に応じて複数のAIエンジンの結果を比較し、校正や元画像との照合を行ってください。